
30초 요약
Pagefind는 정적 사이트의 빌드 결과(HTML)를 스캔해 검색 색인을 만들고, 브라우저가 그 색인을 내려받아 검색하는 라이브러리다. 색인 대상은 data-pagefind-body로 지정한다. 색인 문서는 이 속성이 없으면 <body> 전체를 색인하고, “사이트 어딘가에 data-pagefind-body가 한 번이라도 나오면 이 속성이 없는 페이지는 색인되지 않는다”고 밝힌다. 한국어·중국어·일본어처럼 띄어쓰기가 단어 경계와 다른 언어는 다국어 문서가 “extended release”에서만 지원한다고 명시하는데, 이 extended release가 npx pagefind 실행의 기본값이다. <html lang="ko">만 있으면 별도 설정 없이 한국어로 인식하고, v1.5.0 릴리스부터는 검색어도 브라우저 내장 Intl.Segmenter로 쪼갠다. 이 글은 Pagefind 1.5.2로 최소 한국어 테스트 사이트를 만들어 “김치찌개”, “리액트” 같은 실제 한국어 검색어로 맞는 글이 나오는지 GitHub Actions 러너에서 확인했다.
목표
서버 검색 API가 없는 정적 사이트(빌드 시점에 완성된 HTML만 올라가는 블로그)에 클라이언트 검색을 붙이고, 한국어 검색어를 입력했을 때 실제로 맞는 글이 결과로 나오게 하는 것이 목표다.
원인
정적 사이트는 Elasticsearch·Algolia 같은 서버 쪽 검색 API를 둘 수 없다. Pagefind는 빌드가 끝난 뒤 정적 HTML을 스캔해 색인 파일(청크로 나뉜 메타데이터와 WebAssembly)을 만들고, 브라우저가 검색어와 관련된 조각만 내려받아 검색하는 방식으로 이 문제를 푼다.
한국어는 띄어쓰기가 단어 경계와 일치하지 않는다. “김치찌개는”처럼 명사에 조사가 그대로 붙어 하나의 어절이 된다. 다국어 문서는 중국어·일본어·한국어를 “specialized languages”로 따로 다루며, 이 처리가 “only supported in Pagefind’s extended release, which is the default when running npx pagefind”라고 밝힌다. 색인은 페이지의 <html lang> 값으로 언어를 자동 감지해 언어별로 별도 색인을 만들고, 이 언어는 word stemming을 지원하지 않는다(형태 변화를 자동으로 인식하지 못한다). 다만 Pagefind가 한국어 어절을 실제로 어떻게 나누는지(조사를 분리하는지 등)는 문서에 구체적으로 나와 있지 않고, 이 글에서도 그 내부 동작까지 확인하지는 않았다. 이 글이 실행으로 확인한 것은 “김치찌개”·“리액트” 같은 검색어를 넣었을 때 해당 글이 결과에 나온다는 사실이다.
v1.5.0 릴리스 노트는 “Pagefind now taps into Intl.Segmenter to chop search queries in CJK (Chinese, Japanese, Korean) non-whitespace-delimited languages”라고 밝힌다. 이 문구가 말하는 것은 v1.5.0부터 검색어(query)도 Intl.Segmenter로 쪼갠다는 것이다. Intl.Segmenter는 브라우저 내장 API라 추가로 내려받는 코드가 필요 없다. 체인지로그를 보면 이 글이 쓴 1.5.2 직전 릴리스인 1.5.1은 “crate release only. Fixes busted 1.5.0 deployment of the pagefind crate to crates.io”로 Rust crate 배포만 고친 릴리스이고, 1.5.2는 “subs in jemalloc on Linux musl builds to fix the musl allocator thrashing”로 Linux musl 빌드의 성능 회귀를 고친 릴리스다. 두 릴리스 모두 CJK 처리 자체를 바꾸지는 않았다.
해결 방법
1. Pagefind 설치하기
npm install --save-dev pagefind2. 색인 대상을 data-pagefind-body로 표시하기
본문 영역에만 붙인다.
<article data-pagefind-body> ...본문...</article>색인 문서는 “By default, Pagefind starts indexing from your <body> element”라고 하고, 이어서 “If data-pagefind-body is found anywhere on your site, any pages without this attribute will not be indexed”라고 밝힌다. 즉 이 속성은 “본문만 골라서 태그”하는 선택이 아니라, 사이트 전체를 대상으로 색인 범위를 결정하는 스위치다. 이 스위치는 장점과 위험을 함께 가진다. 장점은 목록 페이지·소개 페이지처럼 검색 결과에서 빼고 싶은 페이지를, 그 페이지에 이 속성을 붙이지 않는 것만으로 자동으로 뺄 수 있다는 것이다. 위험은 반대 방향이다: 글 템플릿에 이 속성 넣는 것을 빠뜨리면, 그 템플릿으로 만들어진 글이 에러 없이 조용히 색인에서 빠진다.
3. 빌드 뒤에 색인 만들기
정적 빌드가 끝난 뒤 그 결과 폴더를 대상으로 CLI를 돌린다.
astro build && npx pagefind --site dist기본 출력은 <지정한 폴더>/pagefind이며 여기에 pagefind.js(검색 엔진 코드)와 pagefind-ui.js·pagefind-ui.css(기본 제공 UI), 언어별 색인 청크가 담긴다.
로컬에서 검색 동작만 시험하려면 정적 자산 폴더에 복사할 필요 없이, config-options 문서가 안내하는 --serve 옵션으로 충분하다. 문서는 이 옵션을 “Serve the site directory after creating the search index. Useful for testing search on a local build of your site without having to serve the site directory manually”라고 설명한다.
npx pagefind --site dist --serveastro dev 같은 프레임워크 개발 서버 화면에서도(빌드 결과가 아니라) 검색을 쓰고 싶을 때만, 만들어진 pagefind 폴더를 정적 자산 폴더(Astro는 public/)에 다시 복사해 둔다. 이때 복사 전에 기존 public/pagefind를 먼저 지워야 한다. 대상 폴더가 이미 있는 상태에서 cp -r dist/pagefind public/pagefind를 그대로 실행하면 dist/pagefind 자체가 기존 폴더 안으로 들어가 public/pagefind/pagefind처럼 한 단계 중첩된다. 게다가 Astro는 빌드할 때 public/의 파일을 그대로 dist/로 복사하므로, 다음 빌드에서는 아직 지우지 않은 public/pagefind의 옛 파일이 그 빌드의 dist/pagefind에 먼저 섞여 들어간다. 그 상태에서 다시 dist/pagefind를 public/pagefind로 복사하면 폴더 중첩이 쌓일 뿐 아니라, 옛 색인 파일이 배포 결과물(dist)에도 그대로 섞여 남는다.
rm -rf public/pagefind && cp -r dist/pagefind public/pagefindpublic/pagefind는 빌드마다 새로 만들어지는 산출물이므로 저장소에 커밋하지 않고 .gitignore에 등록해 둔다.
echo "public/pagefind" >> .gitignore이 블로그(관심거리.log)도 Pagefind로 검색을 제공하는데, 로컬 빌드에서 dist/pagefind를 public/으로 복사하는 빌드 명령이 빌드마다 폴더를 한 단계씩 중첩시켜 크기가 28MB까지 불어난 적이 있어, 복사 전에 지우도록 고쳤다. CI가 만드는 배포 결과물에는 영향이 없었다.
4. 한국어 인식시키기
페이지에 <html lang="ko">만 있으면 추가 설정 없이 한국어로 인식되고, 다국어 문서가 말하는 specialized language 처리(extended release에서만 지원)가 적용된다. 언어가 페이지마다 다르게 감지돼 색인이 여러 개로 쪼개지는 게 싫으면 config-options 문서가 안내하는 --force-language ko(CLI 플래그) 또는 force_language: ko(설정 파일)로 사이트 전체를 한 언어로 강제할 수 있다. 문서는 이 옵션을 “Ignores any detected languages and creates a single index for the entire site as the provided language. Expects an ISO 639-1 code”라고 설명한다.
5. 검색 UI 붙이기
<link href="/pagefind/pagefind-ui.css" rel="stylesheet" /><script src="/pagefind/pagefind-ui.js"></script><div id="search"></div><script> window.addEventListener("DOMContentLoaded", () => { new PagefindUI({ element: "#search", translations: { placeholder: "검색어를 입력하세요", zero_results: "'[SEARCH_TERM]'에 맞는 글이 없습니다", }, }); });</script>translations로 UI 문구를 한국어로 바꾼다. 현재 시작하기 문서는 이 pagefind-ui.js/.css 대신 더 최신 방식인 “Component UI”도 안내하지만, 둘 중 어느 쪽을 골라도 앞서 설명한 색인·언어 감지·검색 동작 자체는 같다.
검색 색인이 든 빌드 결과를 GitHub Pages에 올리는 과정은 Astro 블로그를 GitHub Actions로 배포하기에 있다.
확인
GitHub Actions 러너에 실제 블로그가 아닌 최소 테스트 사이트(한국어 글 두 편)를 새로 만들어 확인했다.
data-pagefind-body를 붙인 한국어 글 두 편(김치찌개 조리법 글, 리액트 훅 글)을 만들고,python3 -m http.server로 러너 안 로컬 서버에 띄운다- 색인을 만들기 전에 검색 페이지를 열어 “검색 색인 없음” 상태를 캡처한다
pagefind --site로 색인을 만든 뒤, 실제 한국어 검색어(“김치찌개”, “리액트”)로 헤드리스 Chromium(Playwright)에서 검색해 맞는 글 제목이 결과에 나오는지 확인하고 다시 캡처한다
검증 환경 4항목
| OS | Ubuntu 24.04.5 |
|---|---|
| pagefind | 1.5.2 |
| Node | 22.23.2 |
| 실행 날짜 | 2026-09-25 |
[PASS] pagefind CLI 설치
[PASS] playwright-core 설치(검색 결과 확인용)
[PASS] 한국어 테스트 글(김치찌개) 준비
[PASS] 한국어 테스트 글(리액트) 준비
서버 시작: 127.0.0.1:8090 (python3 -m http.server 8090 --bind 127.0.0.1 --directory '/tmp/tmp.Dqdb2k82n5/site')
[PASS] 색인을 만들기 전에도 검색 페이지 자체는 러너 로컬 서버(127.0.0.1:8090)에서 200으로 열린다
    > HTTP 200 GET http://127.0.0.1:8090/search.html
[EVIDENCE] 색인을 만들기 전(검색 색인 없음): http://127.0.0.1:8090/search.html 메인 문서 200 · 요청 2건
[PASS] pagefind 색인 생성(site/pagefind/pagefind.js)
[PASS] 색인을 만든 뒤에도 검색 페이지가 러너 로컬 서버(127.0.0.1:8090)에서 200으로 열린다
    > HTTP 200 GET http://127.0.0.1:8090/search.html
[EVIDENCE] 실제 한국어 검색어 김치찌개로 검색한 결과: http://127.0.0.1:8090/search.html 메인 문서 200 · 요청 8건
김치찌개 -> ["김치찌개 끓이는 법"]
[PASS] 실제 한국어 검색어 "김치찌개"로 검색하면 "김치찌개 끓이는 법" 글이 결과에 나온다
리액트 -> ["리액트 useState 훅 사용법"]
[PASS] 실제 한국어 검색어 "리액트"로 검색하면 "리액트 useState 훅 사용법" 글이 결과에 나온다
[EVIDENCE] 비교 이미지와 표: 캡처 2개, 요청 8행, 전후 픽셀 차이 0.39% (4008픽셀)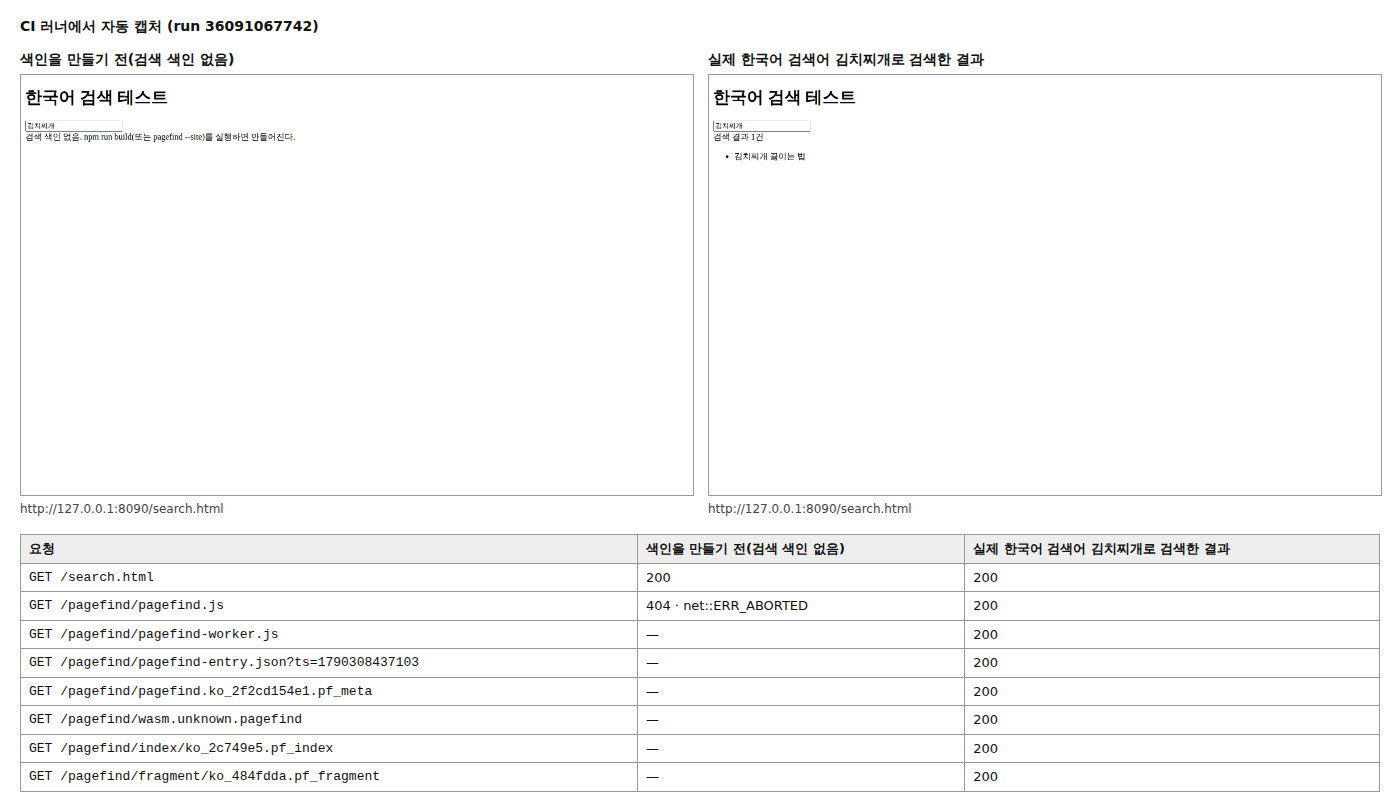
| 요청 | 색인을 만들기 전(검색 색인 없음) | 실제 한국어 검색어 김치찌개로 검색한 결과 |
|---|---|---|
| GET /search.html | 200 | 200 |
| GET /pagefind/pagefind.js | 404 · net::ERR_ABORTED | 200 |
| GET /pagefind/pagefind-worker.js | — | 200 |
| GET /pagefind/pagefind-entry.json?ts=1790308437103 | — | 200 |
| GET /pagefind/pagefind.ko_2f2cd154e1.pf_meta | — | 200 |
| GET /pagefind/wasm.unknown.pagefind | — | 200 |
| GET /pagefind/index/ko_2c749e5.pf_index | — | 200 |
| GET /pagefind/fragment/ko_484fdda.pf_fragment | — | 200 |
주의
- 위 캡처는 실제 PagefindUI 위젯이 아니라, Pagefind의 저수준 JS API(
pagefind.js의search())를 직접 불러 만든 최소 테스트 화면이다. 캡처 타이밍을 안정적으로 맞추려고 입력 즉시 검색을 실행하는 화면을 따로 만들었다. 색인·언어 감지·검색 엔진 자체의 동작은 5단계의 PagefindUI를 쓸 때와 같다 data-pagefind-body는 “전부 아니면 전무”다. 새 페이지 템플릿을 추가할 때 이 속성을 빠뜨리면 그 페이지가 검색에서 조용히 빠진다는 뜻이므로, 템플릿 단위로 한 번만 넣고 잊지 않는 게 안전하다- 한국어는 word stemming을 지원하지 않는다. “찌개”로 검색해서 “찌개들”, “찌개다” 같은 변화형까지 자동으로 묶어 찾아 주지는 않는다
- 이 실습은 blog.hexahub.co.kr 실제 콘텐츠가 아니라 러너에 새로 만든 2페이지짜리 테스트 사이트로 확인했다. 글 수가 많아지면 색인 크기·검색 속도가 달라질 수 있다
자주 묻는 질문
검색 결과가 하나도 안 나온다.
먼저 pagefind --site <폴더>를 정적 빌드가 끝난 뒤에 실행했는지 확인한다. 빌드 전에 실행하면 대상 HTML이 없어 빈 색인이 만들어진다. 다음으로 본문에 data-pagefind-body가 있는지 확인한다. 사이트 전체에 이 속성이 하나도 없으면 <body> 전체가 색인되지만, 다른 페이지 한 곳에라도 이 속성이 있으면 지금 보는 페이지에도 있어야 색인된다(색인 문서).
오타나 일부 글자만 입력해도 찾아지나?
Pagefind는 word stemming을 지원하지 않는다(한국어를 포함한 specialized language 공통). 완전히 다른 단어로 잘못 입력한 오타까지 자동으로 보정해서 찾아 주는 기능은 아니다. 이 글이 실행으로 확인한 것은 “김치찌개”·“리액트”처럼 온전한 단어를 검색어로 넣었을 때 결과가 나온다는 것뿐이고, 오타나 부분 입력에 대한 동작은 따로 확인하지 않았다.
Pagefind 버전이 오래돼도 한국어 검색이 되나?
v1.5.0 릴리스 노트는 “Pagefind now taps into Intl.Segmenter to chop search queries in CJK (Chinese, Japanese, Korean) non-whitespace-delimited languages”라고 밝힌다. 이 문구대로면 v1.5.0 전에는 검색어 쪽에 이 처리가 없었다는 뜻이므로, v1.5.0 이상을 쓰는 게 안전하다.