
30초 요약
한글이 물음표나 네모, 한글처럼 알 수 없는 기호로 보이는 건 대부분 “실제 파일의 문자 인코딩”과 “브라우저에 선언한 인코딩”이 다르기 때문이다. 브라우저는 문자 인코딩을 정할 때 정해진 순서를 따르는데, BOM과 사용자가 직접 지정한 값 다음으로 HTTP Content-Type 헤더의 charset이 HTML <meta charset>보다 우선한다(WHATWG HTML 표준). 그래서 <meta charset="utf-8">을 제대로 넣었어도 서버가 Content-Type 헤더에 다른 charset을 실어 보내면 meta 선언은 무시된다. 반대로 헤더와 meta가 둘 다 utf-8이라고 선언해도, 실제 파일이 UTF-8이 아닌 다른 인코딩(EUC-KR, CP949 등)으로 저장돼 있으면 그 선언 자체가 거짓이 되어 여전히 깨진다. 이 글에서 러너로 실행 재현한 것은 뒤의 경우, 즉 「헤더·meta는 둘 다 utf-8인데 실제 파일만 EUC-KR인」 상황이다(아래 「확인」 참고). HTTP 헤더가 meta보다 우선한다는 규칙 자체는 실행으로 재현하지 않고 WHATWG 표준 문서를 대조해 확인했다. 해결은 세 가지를 맞추는 것이다: 파일의 실제 인코딩을 UTF-8로 통일하고, <meta charset="utf-8">을 head 맨 앞(문서 첫 1024바이트 안)에 두고, 서버가 Content-Type 헤더에 charset=utf-8을 실제로 내려보내게 설정한다.
증상/목표
브라우저로 페이지를 열면 한글 부분이 다음과 같은 모습으로 보인다.
한글 샘플처럼 라틴 문자와 기호가 뒤섞여 보임 (UTF-8 바이트를 다른 인코딩으로 잘못 해석한 전형적인 모습)����같은 사각형이나 물음표로 보임 (해석할 수 없는 바이트를 대체 문자로 표시)- 영어·숫자·태그는 멀쩡한데 한글만 깨짐
view-source로 봐도 소스 자체(파일)는 정상적인 한글일 수도, 이미 깨진 바이트일 수도 있다. 목표는 파일의 실제 인코딩, HTML의 <meta charset> 선언, 서버가 보내는 Content-Type 헤더의 charset 세 가지를 UTF-8로 일치시켜서 어떤 브라우저·환경에서도 한글이 정상적으로 보이게 만드는 것이다.
원인
브라우저가 HTML 문서의 문자 인코딩을 결정하는 절차는 WHATWG HTML 표준의 “인코딩 결정” 알고리즘에 정해져 있다. 우선순위를 요약하면 다음과 같다(표준 문서).
- BOM(Byte Order Mark): 문서 앞에 BOM이 있으면 그 인코딩을 확실한(certain) 신뢰도로 채택한다
- 사용자가 직접 지정한 인코딩: 브라우저에서 사람이 수동으로 인코딩을 바꾼 경우
- HTTP 전송 계층(Content-Type 헤더)의 charset: 표준은 “전송 계층이 문자 인코딩을 지정하고 그것을 지원한다면, 그 인코딩을 확실한 신뢰도로 반환한다”고 규정한다
<meta charset>프리스캔: 문서의 첫 1024바이트를 미리 훑어<meta charset>을 찾는다. 찾으면 “잠정적(tentative)” 신뢰도로 채택한다- 그 이후로 상위 문서의 인코딩, 방문 기록, 자동 감지 등이 차례로 시도된다
여기서 핵심은 HTTP 헤더가 meta 태그보다 먼저, 더 높은 신뢰도로 적용된다는 것이다. 즉 <meta charset="utf-8">을 정확히 넣었더라도, 서버가 응답 헤더에 Content-Type: text/html; charset=iso-8859-1처럼 다른 값을 실어 보내면 브라우저는 meta 태그를 무시하고 헤더 값을 그대로 쓴다.
meta 태그 자체에도 제약이 있다. MDN 문서는 “문자 인코딩을 선언하는 <meta> 요소는 반드시 문서의 첫 1024바이트 안에 완전히 위치해야 한다”고 밝히고 있다(MDN meta 문서). head 안에 긴 인라인 스타일이나 스크립트, 주석을 charset 선언보다 앞에 두면 이 1024바이트를 넘겨서 브라우저가 선언을 아예 못 읽을 수 있다. 같은 문서는 HTML5에서 charset 속성 값이 대소문자 구분 없이 반드시 utf-8과 일치해야 한다고도 설명한다.
가장 흔한 실제 원인은 이 두 규칙이 겹쳐서 생긴다.
- 서버 설정(nginx
charset, ApacheAddDefaultCharset등)이Content-Type헤더에 charset을 아예 안 붙이거나, UTF-8이 아닌 값을 붙인다 - 텍스트 에디터·CMS·엑셀 내보내기 등이 파일을 EUC-KR·CP949·Windows-1252 같은 다른 인코딩으로 저장했는데, meta나 헤더는 그대로
utf-8이라고 선언돼 있다(또는 그 반대) - meta charset 선언이 1024바이트를 넘는 위치에 있어 아예 무시된다
세 번째 경우, 즉 선언은 있는데 실제 파일 인코딩과 다른 상황이 특히 헷갈린다. 헤더도 meta도 “UTF-8”이라고 말하고 있어서 설정만 봐서는 문제가 안 보이지만, 실제 바이트가 UTF-8이 아니면 그 선언 자체가 틀린 것이므로 브라우저는 잘못된 방식으로 바이트를 해석해 깨진 문자를 그린다.
해결 방법
1. 실제 파일 인코딩을 확인하고 UTF-8로 통일한다
먼저 문제의 HTML 파일이 실제로 어떤 바이트로 저장돼 있는지 확인한다. 리눅스·macOS 터미널에서 file -i 파일명으로 추정 인코딩을 볼 수는 있지만, file은 EUC-KR을 정확히 판별하지 못하고 unknown-8bit나 iso-8859-1 같은 엉뚱한 값으로 표시하는 경우가 많아 참고용으로만 쓴다.
file -i index.html# index.html: text/html; charset=unknown-8bit ← EUC-KR 파일인데 file이 못 알아본 예UTF-8인지 아닌지는 iconv로 실제 디코딩을 시도해 성공·실패로 판단하는 편이 정확하다. UTF-8이면 종료 코드 0으로 조용히 끝나고, UTF-8이 아니면 오류를 내며 0이 아닌 코드로 실패한다.
iconv -f UTF-8 -t UTF-8 index.html > /dev/nullecho $? # 0이면 UTF-8, 0이 아니면 UTF-8이 아니다UTF-8이 아니라면 변환한다. 윈도우에서 저장한 한글 파일이면 EUC-KR 대신 CP949로 변환하는 편이 안전하다. CP949(Unified Hangul Code)는 EUC-KR의 상위 집합으로, EUC-KR에는 없는 완성형 한글 음절 약 8000자를 더 포함하기 때문에 EUC-KR로 지정하면 그 문자들에서 변환이 실패할 수 있다(Unified Hangul Code, Wikipedia).
iconv -f CP949 -t UTF-8 index.html > index.utf8.html에디터(VS Code 등)에서 “인코딩을 사용해 다시 열기”로 원래 인코딩을 지정해 정상적으로 읽은 뒤, “인코딩을 사용해 저장”으로 UTF-8을 선택해도 된다. 파일의 실제 바이트를 UTF-8로 바꾸는 것이 먼저다. 선언만 UTF-8로 고치고 파일은 그대로 두면 이번 글에서 재현하는 것과 같은 증상이 계속된다.
2. <meta charset="utf-8">을 head 맨 앞에 둔다
<meta charset>은 문서의 첫 1024바이트 안에 있어야 인식된다(MDN meta 문서). <head>를 열자마자 다른 태그보다 먼저 넣는다.
<!DOCTYPE html><html lang="ko"> <head> <meta charset="utf-8" /> <title>페이지 제목</title> <!-- 다른 meta, link, style은 이 뒤에 --> </head> <body> ... </body></html>3. 서버 Content-Type 헤더에 charset=utf-8이 실제로 내려가는지 설정한다
HTTP 헤더가 meta보다 우선하므로, 서버가 Content-Type 응답 헤더에 올바른 charset을 보내는지가 더 중요하다.
nginx는 charset 지시어로 Content-Type 헤더에 charset을 추가한다. 기본값은 charset off;(추가하지 않음)다(nginx 문서).
http { charset utf-8; # 또는 server{}, location{} 블록 단위로도 지정할 수 있다}Apache는 AddDefaultCharset 지시어를 쓴다. 기본값은 AddDefaultCharset Off이고, 값 없이 AddDefaultCharset On만 켜면 기본 charset으로 iso-8859-1이 붙는다는 점을 주의해야 한다(Apache 문서). UTF-8을 쓰려면 값을 명시한다.
AddDefaultCharset utf-8Node.js 같은 런타임으로 직접 서버를 작성한다면 응답을 보낼 때 Content-Type 헤더 자체에 charset을 명시적으로 넣어야 한다. 헤더 형식은 Content-Type: text/html; charset=utf-8이고, charset 값은 대소문자를 구분하지 않지만 소문자 표기가 권장된다(MDN Content-Type 문서).
확인
실제 서비스에서는 브라우저 개발자 도구의 네트워크 탭에서 문서 요청의 응답 헤더에 Content-Type: text/html; charset=utf-8이 있는지 보거나, curl -sD - -o /dev/null <URL>로 응답 헤더만 확인하면 된다. HEAD 요청(curl -I)은 서버가 HEAD를 구현하지 않았을 때 다른 오류 응답의 헤더를 잘못 읽을 수 있어 피한다.
이 글의 verify.sh는 GitHub Actions 러너 위에 파이썬 표준 라이브러리로 만든 최소 HTTP 서버 두 개를 띄워 재현했다(실제 nginx·Apache가 아니라, Content-Type 헤더를 직접 통제할 수 있는 대체 서버다). 같은 HTML을 UTF-8 그대로 서빙하는 서버(수정 후)와, 실제 바이트는 EUC-KR로 다시 저장했지만 Content-Type과 <meta charset>은 둘 다 utf-8이라고 선언한 서버(수정 전)를 비교했다. 수정 전 파일은 선언대로 UTF-8로 해석하려고 하면 디코딩에 실패하는 것을 실행으로 확인했고, 두 서버의 실제 응답 화면을 각각 캡처했다. 아래 캡처와 요청 표를 참고한다.
verify.sh로 실행 재현한 것은 「실제 파일은 EUC-KR인데 헤더·meta는 둘 다 utf-8로 선언된」이 한 가지 상황뿐이다. 앞서 원인·해결 단계에서 설명한 「HTTP 헤더가 meta보다 우선한다」는 규칙은 이 서버들로 재현한 것이 아니라 WHATWG 표준 문서를 대조해 확인한 내용이다.
검증 환경 3항목
| OS | Ubuntu 24.04.5 |
|---|---|
| Python | 3.12.3 |
| 실행 날짜 | 2026-09-25 |
[PASS] 테스트 페이지 소스를 준비했다
[PASS] 원본을 EUC-KR 바이트로 다시 저장했다(수정 전 상황 재현용)
[PASS] 수정 후 파일은 UTF-8 그대로 뒀다
[XFAIL] before.html을 선언대로(UTF-8) 디코딩 — 예상된 실패 재현됨 (/UnicodeDecodeError.*codec can't decode byte/)
    > UnicodeDecodeError: 'utf-8' codec can't decode byte 0xc0 in position 70: invalid start byte
서버 시작: 127.0.0.1:8080 (python3 '/tmp/tmp.bLZlRQ68hl/server.py' 8080 'text/html; charset=utf-8' '/tmp/tmp.bLZlRQ68hl/before.html')
[PASS] 수정 전 서버 응답의 Content-Type에 charset=utf-8이 선언돼 있다(그러나 실제 파일은 EUC-KR이다)
    > HTTP 200 GET http://127.0.0.1:8080/
    > Content-Type: text/html; charset=utf-8
[EVIDENCE] 수정 전: 파일은 EUC-KR, 선언은 UTF-8: http://127.0.0.1:8080/ 메인 문서 200 · 요청 1건OK
[PASS] after.html은 선언대로(UTF-8) 디코딩된다
서버 시작: 127.0.0.1:8081 (python3 '/tmp/tmp.bLZlRQ68hl/server.py' 8081 'text/html; charset=utf-8' '/tmp/tmp.bLZlRQ68hl/after.html')
[PASS] 수정 후 서버 응답의 Content-Type에 charset=utf-8이 선언돼 있고 실제 파일도 UTF-8이다
> HTTP 200 GET http://127.0.0.1:8081/
> Content-Type: text/html; charset=utf-8
[EVIDENCE] 수정 후: 파일·선언 모두 UTF-8: http://127.0.0.1:8081/ 메인 문서 200 · 요청 1건
[EVIDENCE] 비교 이미지와 표: 캡처 2개, 요청 1행, 전후 픽셀 차이 1.01% (10299픽셀)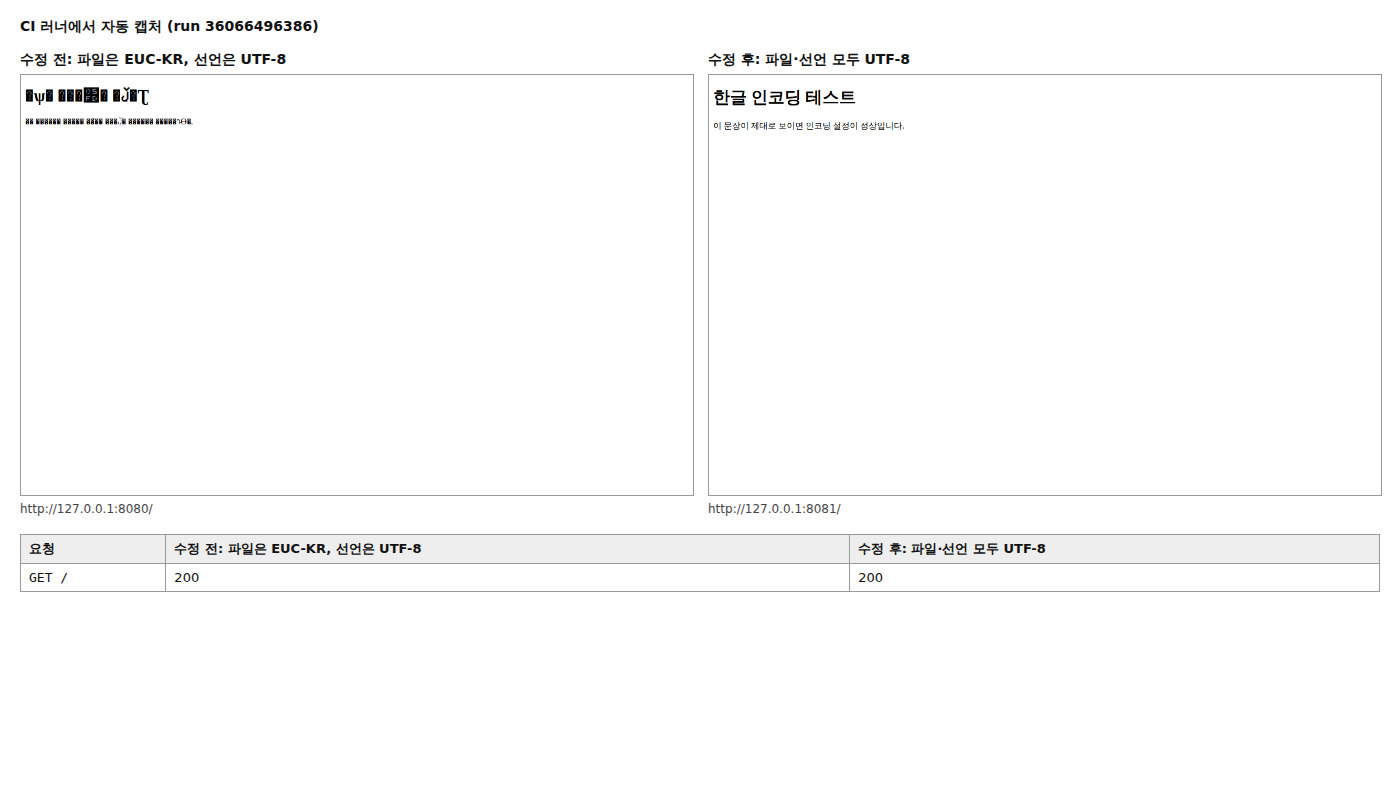
주의
- HTTP 헤더가 meta보다 우선한다(WHATWG 표준).
<meta charset="utf-8">만 고치고 서버 헤더는 그대로 두면 안 고쳐진다 - Apache에서
AddDefaultCharset On처럼 값 없이 켜면 기본값이iso-8859-1이라 UTF-8 콘텐츠에는 맞지 않는다. 반드시AddDefaultCharset utf-8처럼 값을 명시한다(Apache 문서) <meta charset>은 문서 첫 1024바이트 안에 있어야 인식된다. head 앞부분에 긴 주석이나 인라인 리소스를 두면 이 선언이 무시될 수 있다(MDN meta 문서)- 헤더와 meta 선언이 서로 일치해도, 실제 파일이 그 인코딩으로 저장돼 있지 않으면 선언 자체가 틀린 것이라 여전히 깨진다. 선언을 고치기 전에 파일의 실제 인코딩부터 확인한다
자주 묻는 질문
meta charset과 Content-Type 헤더의 charset이 다르면 어떻게 되나?
HTTP 헤더가 이긴다. WHATWG 표준의 인코딩 결정 절차에서 전송 계층(HTTP 헤더)의 charset은 “확실한(certain)” 신뢰도로 먼저 채택되고, meta 태그는 그보다 늦게 “잠정적(tentative)” 신뢰도로만 검토된다(표준 문서). 헤더가 있으면 meta 값은 사실상 무시된다.
Content-Type 헤더에 charset이 아예 없으면 항상 깨지나?
꼭 그렇지는 않다. 헤더에 charset이 없으면 브라우저는 문서 첫 1024바이트에서 <meta charset>을 찾고, 그것도 없으면 자동 감지 등 다음 단계로 넘어간다(표준 문서). 하지만 이 경로는 브라우저·환경마다 결과가 달라질 수 있어 신뢰할 수 없다. 헤더에 명시하는 쪽이 안전하다.
EUC-KR·CP949로 저장된 옛 파일은 charset 선언만 utf-8로 바꾸면 되나?
아니다. 선언과 실제 파일 인코딩이 다르면 오히려 더 확실하게 깨진다. 파일 자체를 UTF-8로 다시 저장(또는 변환)한 다음에 선언을 UTF-8로 맞춰야 한다.
정적 파일 서버(nginx 등)와 동적 페이지(애플리케이션 서버)를 같이 쓰면 둘 다 설정해야 하나?
그렇다. 정적 HTML은 nginx·Apache 같은 웹 서버의 charset 설정이 적용되고, 애플리케이션 서버가 직접 만들어 내려보내는 응답은 그 서버(또는 프레임워크)가 스스로 Content-Type 헤더를 설정해야 한다. 리버스 프록시 뒤에 있다면 프록시가 헤더를 덮어쓰지 않는지도 확인한다.
참고 자료
- html.spec.whatwg.org/multipage/parsing.html
- developer.mozilla.org/en-US/docs/Web/HTTP/Reference/Headers/Content-Type
- developer.mozilla.org/en-US/docs/Web/HTML/Reference/Elements/meta
- nginx.org/en/docs/http/ngx_http_charset_module.html
- httpd.apache.org/docs/2.4/mod/core.html
- en.wikipedia.org/wiki/Unified_Hangul_Code